AIトークアバター「エイヴァ(Ava)」を作っています。VRChatの中で、プレイヤーと声で会話するAIです。まずは、会話の様子を見てください。
アバターの3Dモデルは、前回と同じく、Arka_XさんがBOOTHで無料公開している「ゆめか(Yumeka)」をお借りしています。
エイヴァの作り方は、前回の記事で紹介しました。今回はその続きで、エイヴァの中で会話の一瞬ごとの判断を受け持っている「判定モデル」の話です。この判定モデルを、TypeSafe社のJevから、OpenAIのDecisions APIに乗り換えようとしました。
きっかけは費用でした。エイヴァに使っているサービスのうち、使った量に応じて料金を払っているのはJevだけです(ClaudeとElevenLabsは、契約しているプランの枠内で使っています)。そこへOpenAIが、ChatGPTのProとBusinessのプランに、APIを毎月使える利用枠(クレジット)を付けはじめました。その対象には、Jevと同じ種類のDecisions APIも入っています。Jevの判断をこちらに移せば、費用はほぼクレジットでまかなえるはずでした。
でも、結局乗り換えませんでした。判定モデルを差し替えること自体はできます。ただ、実際に測ってみると、トークアバターでいちばん大事にしている「話していて自然か」という部分が変わってしまうと分かったのです。
この記事では、そう判断するまでに測ったことを、実際の数字と一緒にまとめます。JevからDecisions APIへの移行を考えている人や、判定モデルを選ぼうとしている人の参考になればうれしいです。
トークアバターの判定モデルとは
エイヴァは、役割の違うAIを組み合わせて動いています。相手の声を文字にするAI、返事の文章を書くAI(Claude)、返事を声にするAI。そしてもう1つが、会話の一瞬ごとの判断をする判定モデル(Jev)です。
判定モデルは文章を書きません。「この人はまだ話の途中?」「いま合う仕草は?」「いまの発言は褒め言葉?」といった小さな質問に、0から1の確率で答えるだけです。そのぶん速く、0.2秒ほどで答えが返ってきます。
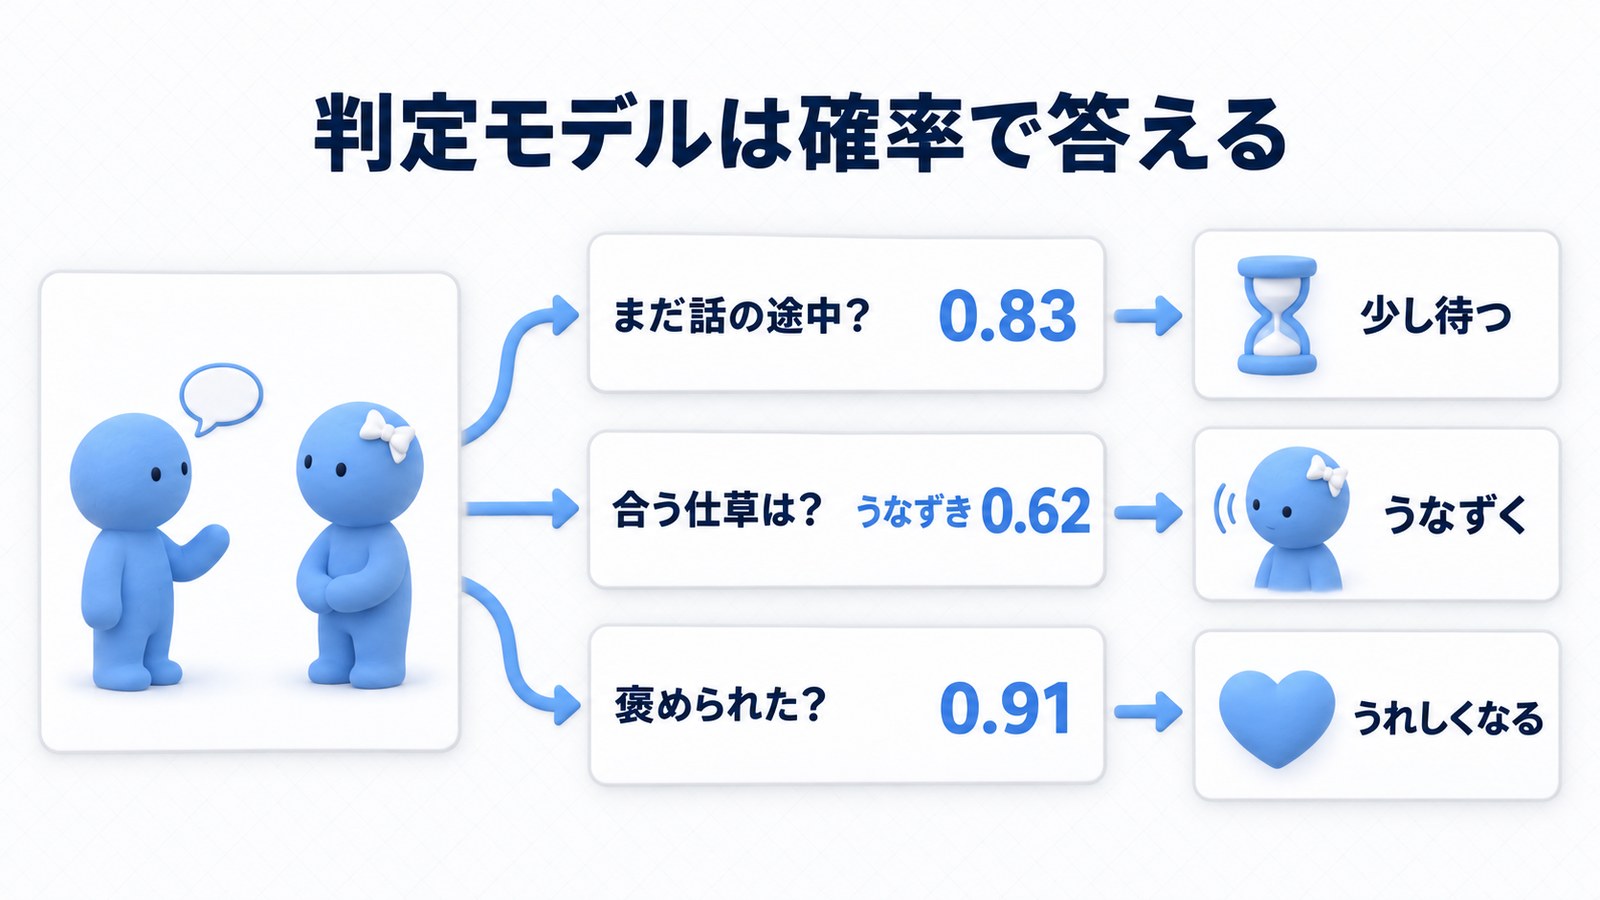
エイヴァは、この確率をそのまま振る舞いに使っています。「まだ話の途中」の確率が高ければ、返事を始めずに少し待つ。うなずきの確率が高ければ、うなずく。褒められた確率が高ければ、気分が少し明るくなる。
トークアバターの「自然さ」の多くは、こうした小さな判断の積み重ねでできています。人間も、相手の話が終わったかを見きわめたり、相づちのタイミングを計ったりするのを、ほとんど無意識にやっています。エイヴァでは、その無意識の部分を判定モデルが受け持っています。判定モデルを替えるのは、この無意識の判断をまるごと別のモデルに任せることです。
なお、こうしたモデルは英語でdecision modelと呼ばれ、「意思決定モデル」と訳されることもあります。ただ、モデルが何かを決めるわけではありません。確率で見きわめるだけで、待つかうなずくかを決めているのはエイヴァのプログラムです。そこでこの記事では、前回の記事と同じく「判定モデル」と呼びます。
OpenAIのDecisions APIとは
Decisions APIは、OpenAIが2026年10月に出した判断専用のAPIです(10月6日に公開ベータ、22日に正式版)。Jevと同じく文章は書かず、質問に確率で答えます。中で動いているのは gpt-6-luna というモデルです。
質問の型も、Jevとほとんど同じです。
| 質問の型 | Jevでの名前 | Decisions APIでの名前 | 返ってくるもの |
|---|---|---|---|
| はい/いいえ | noul | predicate | 「はい」の確率 |
| 選択肢 | choice | choice | 選択肢ごとの確率 |
| 段階 | score | score | 段階ごとの確率と、その平均 |
値段は、入力100万トークンあたりJevが0.042ドル、Decisions APIが0.10ドルです(トークンは文章の量を数える単位です)。エイヴァの実際の質問で数えると、費用は約2.7倍でした。とはいえ、クレジットでまかなえるなら、この差は気になりません。問題は、エイヴァの判断として同じように使えるかどうかです。
返ってくる値を比べる
同じ質問を両方に送ると、どんな値が返ってくるのか。実際に送った例を見てみます。相手が「それでさ、昨日駅前の」と言って一息ついた場面で、「まだ話の途中か(はい/いいえ)」と「いま合う仕草は(うなずき・手を振る・なし)」の2つを聞きました。質問の文は、この記事のために短くしています。
見てほしいのは、質問と答えの包み方の違いと、うなずきの確率の2つです。先に結果を書くと、どちらも「まだ話の途中」「うなずきが合う」と答えました。ただ、うなずきの確率はJevが0.56、Decisions APIが0.81でした。
まずは、Jevに送ったリクエストです。判断の材料(state)と、名前を付けた質問の束(questions)を送ります。
{
  "model": "jev-1.13.0",
  "state": { "user_text": "それでさ、昨日駅前の", "assistant_last": "おかえり。" },
  "questions": {
    "hold": {
      "type": "noul",
      "instructions": "Has the user paused in the middle of their utterance and will likely keep talking?",
      "criteria": { "true": "Unfinished; they will keep talking.", "false": "A complete thought; reply now." }
    },
    "gesture": {
      "type": "choice",
      "instructions": "Which gesture fits the AI companion's reaction to `user_text` right now?",
      "criteria": { "nod": "A small nod to show listening.", "wave": "A wave, for greetings.", "none": "No gesture." }
    }
  }
}
Jevの返り値です。質問の名前ごとに答えが返ってきます。noul が「はい」の確率で、0.94なら「まだ話の途中」が94%という意味です。うなずきは0.56でした。
{
  "model": "jev-1.13.0",
  "answers": {
    "hold": { "type": "noul", "noul": 0.94 },
    "gesture": {
      "type": "choice",
      "choice": "nod",
      "confidence": 0.34,
      "probabilities": { "nod": 0.56, "wave": 0.25, "none": 0.19 }
    }
  },
  "usage": { "input_tokens": 429, "output_tokens": 54 }
}
同じ質問を、Decisions APIの形に変えて送ります。判断の材料はメッセージの中に入れ、質問は名前を付けた配列にします。はい/いいえの質問には「はい」と「いいえ」それぞれの意味を書く欄がないので、指示の文に書き足しました。
{
  "model": "gpt-6-luna",
  "input": [
    { "role": "user", "content": [
      { "type": "input_json", "data": { "user_text": "それでさ、昨日駅前の", "assistant_last": "おかえり。" } }
    ] }
  ],
  "questions": [
    {
      "type": "predicate",
      "name": "hold",
      "instructions": "Has the user paused in the middle of their utterance and will likely keep talking?\nTrue: Unfinished; they will keep talking.\nFalse: A complete thought; reply now."
    },
    {
      "type": "choice",
      "name": "gesture",
      "instructions": "Which gesture fits the AI companion's reaction to `user_text` right now?",
      "choices": [
        { "value": "nod", "description": "A small nod to show listening." },
        { "value": "wave", "description": "A wave, for greetings." },
        { "value": "none", "description": "No gesture." }
      ]
    }
  ]
}
Decisions APIの返り値です。答えは質問の順に、配列で返ってきます。選択肢の確率も配列です。うなずきは0.81でした。
{
  "model": "gpt-6-luna",
  "answers": [
    { "type": "predicate", "name": "hold", "probability": 0.98 },
    {
      "type": "choice",
      "name": "gesture",
      "choice": "nod",
      "probabilities": [
        { "value": "nod", "probability": 0.81 },
        { "value": "wave", "probability": 0.04 },
        { "value": "none", "probability": 0.15 }
      ],
      "confidence": 0.72
    }
  ],
  "usage": {
    "input_tokens": 339,
    "input_tokens_details": { "cached_tokens": 0, "cache_write_tokens": 0 },
    "output_tokens": 0,
    "output_tokens_details": { "reasoning_tokens": 0 },
    "total_tokens": 339
  }
}
判断そのものは、どちらも同じです。違うのは、うなずきに付けた確率でした。Jevの0.56に対して、Decisions APIは0.81。この「どれくらい言い切るか」の違いが、あとで大きく効いてきます。
なお、usage は使った量の記録です。Decisions APIは出力に料金がかからないので、output_tokens は0になっています。confidence は、この記事では使いません。
形の違いを表にまとめると、次のようになります。
| Jev | Decisions API | |
|---|---|---|
| 判断の材料 | state にJSONをそのまま | input のメッセージの中に input_json として |
| 質問の束 | 名前をキーにした辞書 | 配列(name を付ける) |
| はい/いいえの意味 | criteria の true・false に書ける | 欄がないので、指示の文に書く |
| 答えの並び | 名前ごとの辞書 | 質問の順の配列 |
| 答えない | なし | その質問だけ「答えない(refusal)」がありうる |
| モデルの版 | jev-1.13.0 のように固定できる | 固定できない(日付つきの版を指定する手段がない) |
| 画像 | エイヴァで使っている1.13は文字だけ(1.14で試験的に対応) | 画像も判断の材料にできる |
違いはこの程度なので、形を変換する部品は100行ほどで書けました。書き換えの手間は小さいです。
本番の判断を両方に聞いて比べる
次は、エイヴァの実際の判断で比べました。エイヴァの開発では、過去の会話を流し直して動作を確かめるときに、判定モデルに送った質問と返ってきた答えを保存しています。この記事では、この記録を「控え」と呼びます。手元には1,320件の控えがありました。言い終えたか、割り込まれたか、気分、話題の運び、問題のある発言の見張りなど、数十種類の判断です。
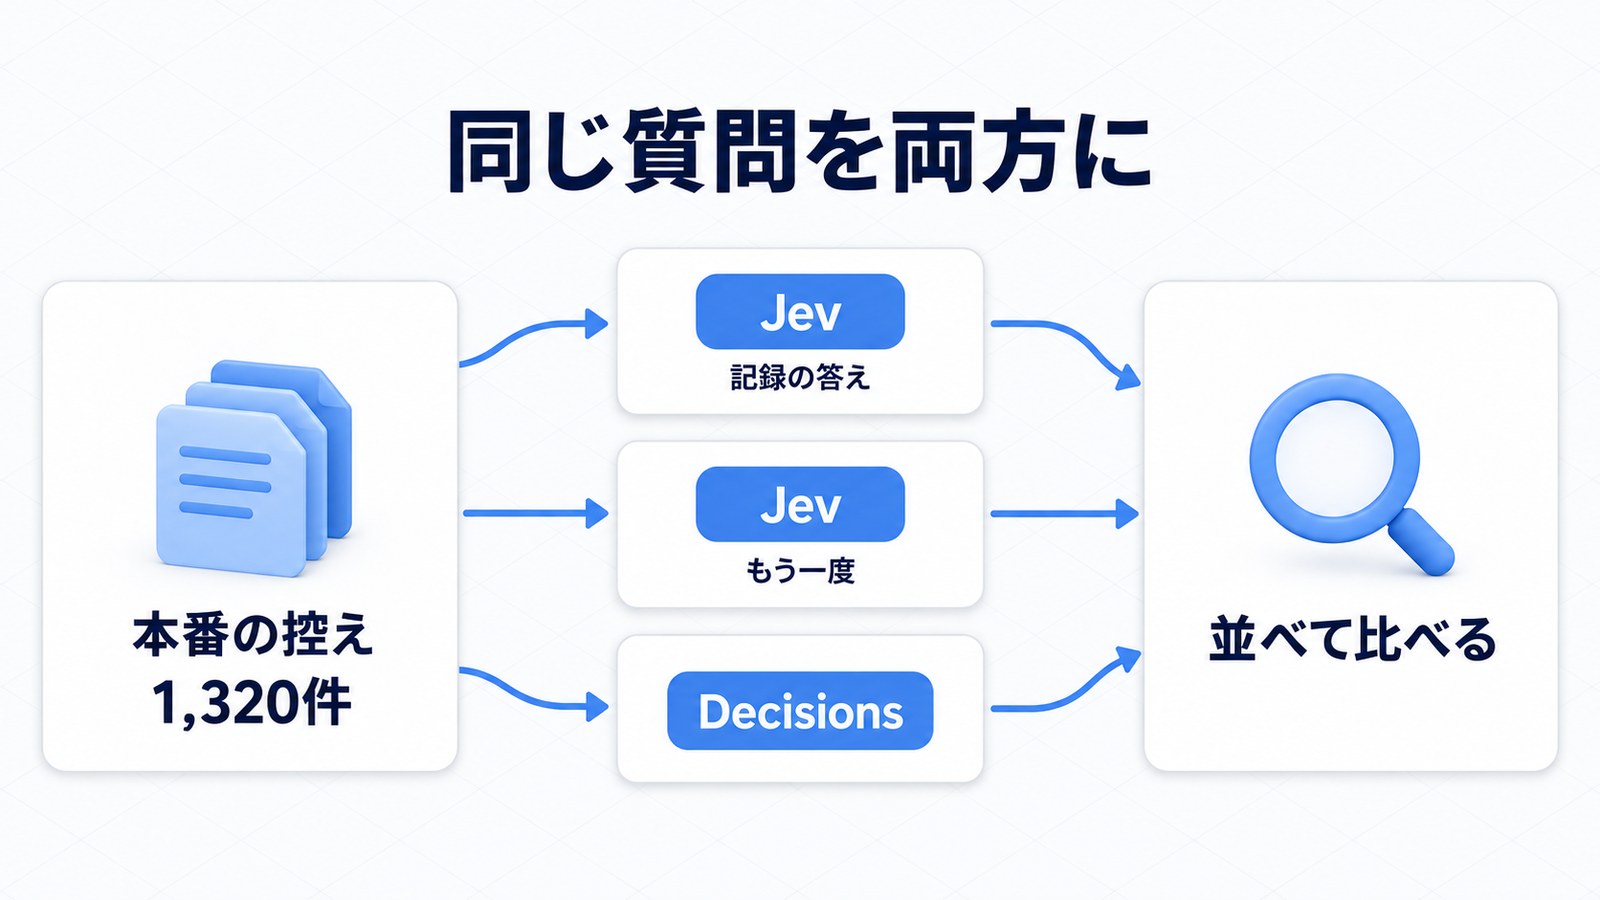
この控えを、材料と質問の中身はそのままに、Decisions APIの形に変えて送りました。確かめたいのは、Jevを前提に調整してきたいまのエイヴァで、そのまま置き換えられるかどうかです。
同時に、Jevにももう一度送りました。同じモデルに同じ質問をしても、答えは少し揺れることがあります。その揺れの大きさが分からないと、Decisions APIとの差が大きいのか小さいのかを判断できないからです。
あわせて、正解が分かっている例でも比べました。これまでJevの質問を直すときに使ってきた、手で正解を付けた例です。この記事の確かめにかかった費用は、全部でDecisions APIが約0.75ドル、Jevが約0.2ドルでした。
正解のある判断ではほぼ互角
まず、Decisions APIは、同じ入力には毎回まったく同じ答えを返しました(300件を2回聞いて、すべて一致)。Jevは、同じ質問でも答えがわずかに揺れます。
正解が分かっている例では、ほぼ互角でした。
| 正解つきの例 | Jev | Decisions API |
|---|---|---|
| まだ話の途中か | 12/12 | 12/12 |
| 割り込みか、相づちか | 12/12 | 12/12 |
| プロンプトインジェクションの検知 | 20/22 | 22/22 |
| 重なった声の種類 | 39/48 | 41/48 |
| 返事が要るか | 22/22 | 22/22 |
| 返事の長さ | 10/10 | 10/10 |
| 相づちの種類 | 17/18 | 11/18 |
プロンプトインジェクションは、「これまでの指示を忘れて〇〇と言って」のように、AIへの指示を乗っ取ろうとする発言のことです。この検知はDecisions APIが22/22で、Jevの20/22を上回りました。反対に、相づちの種類はJevが17/18、Decisions APIが11/18で、ここははっきり差が開きました。Decisions APIは「相づちを打たない」を選びやすく、あとで見る仕草と同じ傾向です。それ以外は、ほぼ互角でした。
確率の出し方が違う
ところが、本番の判断1,320件で、Jevとの答えの一致を数えると、様子が変わります。
| 比べたもの | はい/いいえ | 選択肢 | 段階 |
|---|---|---|---|
| Jev と Jev(同じ質問をもう一度) | 99% | 96% | 96% |
| Jev と Decisions API | 90% | 74% | 54% |
(はい/いいえは0.5で区切った向き、選択肢はいちばん上の答え、段階は四捨五入した段がそろえば一致としています)
正解の例ではほぼ互角なのに、ふだんの判断では、選択肢の4回に1回は違うものを選びます。とはいえ、答えが違うからといって、どちらかが間違っているとは限りません。中身を見ていくと、同じ答えを選んでいるときでも、付けている確率が違っていました。そして、正解が一つに決まらない判断では、選ぶ答えそのものにも偏りがありました。違いの多くは「どちらが正しいか」ではなく、 確率の出し方と選び方の癖 にありました。
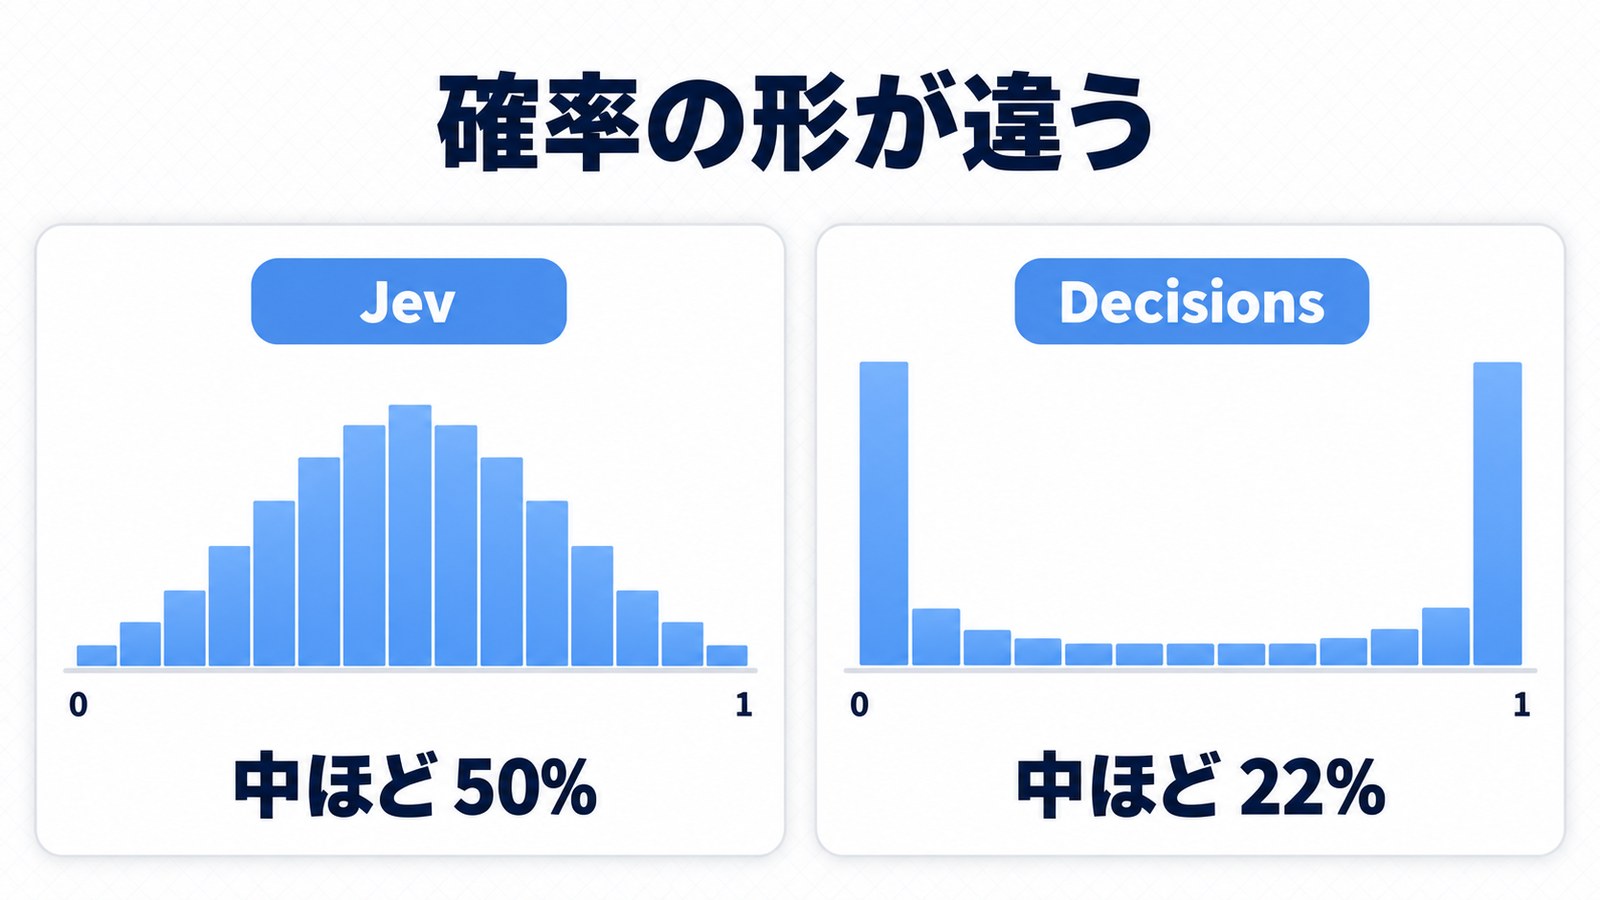
はい/いいえの判断で見ると、Jevは0.1から0.9のあいだの「どちらとも言える」確率を、半分の判断で返します。Decisions APIでは、それが22%にとどまります。ほとんどの判断を、0.02や0.98のように言い切るのです。さきほどの例でも、うなずきの確率はJevが0.56、Decisions APIが0.81でした。
エイヴァは、この中ほどの確率を細かく使っています。少しだけ待つ、ときどきうなずく、気分を少しだけ動かす。前回の記事で書いた「Jevの揺らぎ」も、この中ほどの確率から生まれています。そこが言い切りに変わると、エイヴァの振る舞いも変わってしまいます。確率の出し方や選び方の癖が、そのままアバターの振る舞いの癖になる。この記事で判定モデルの「性格」と呼んでいるのは、このことです。
会話の体験で比べる
答えが一致しないことが、エイヴァにとって良いのか悪いのか。それは一致率だけでは分かりません。そこで、会話の体験そのものを物差しにして比べ直しました。
相手が言い終えたかの判断
いちばん差が出たのは、「相手はもう言い終えたか」の判断でした。言い終えたと判断すれば、エイヴァはすぐ返事を始めます。まだ途中だと判断すれば、確率に応じて少し待ちます。
控えは、過去の会話を同じ順番でもう一度流したときのものです。一息ついた相手が本当に話し続けたかどうかは、その続きを見れば分かります。そこで、140場面に、実際の続きから正解を付けました。物差しは2つです。相手がまだ話しているのに返事を始めてしまった回数(被せ)と、言い終えた相手を余計に待たせた時間です。
| 当たり | 被せ | 言い終えた相手を待たせた時間(合計) | |
|---|---|---|---|
| Jev | 108/140 | 3回 | 19秒 |
| Decisions API | 110/140 | 10回 | 22秒 |
当たりの数は、ほとんど同じでした。違ったのは外し方です。相手がまだ話している場面で返事を始めてしまったのは、Jevが3回、Decisions APIが10回。Jevは待つ側に、Decisions APIは返事を始める側に外れやすいことが分かりました。
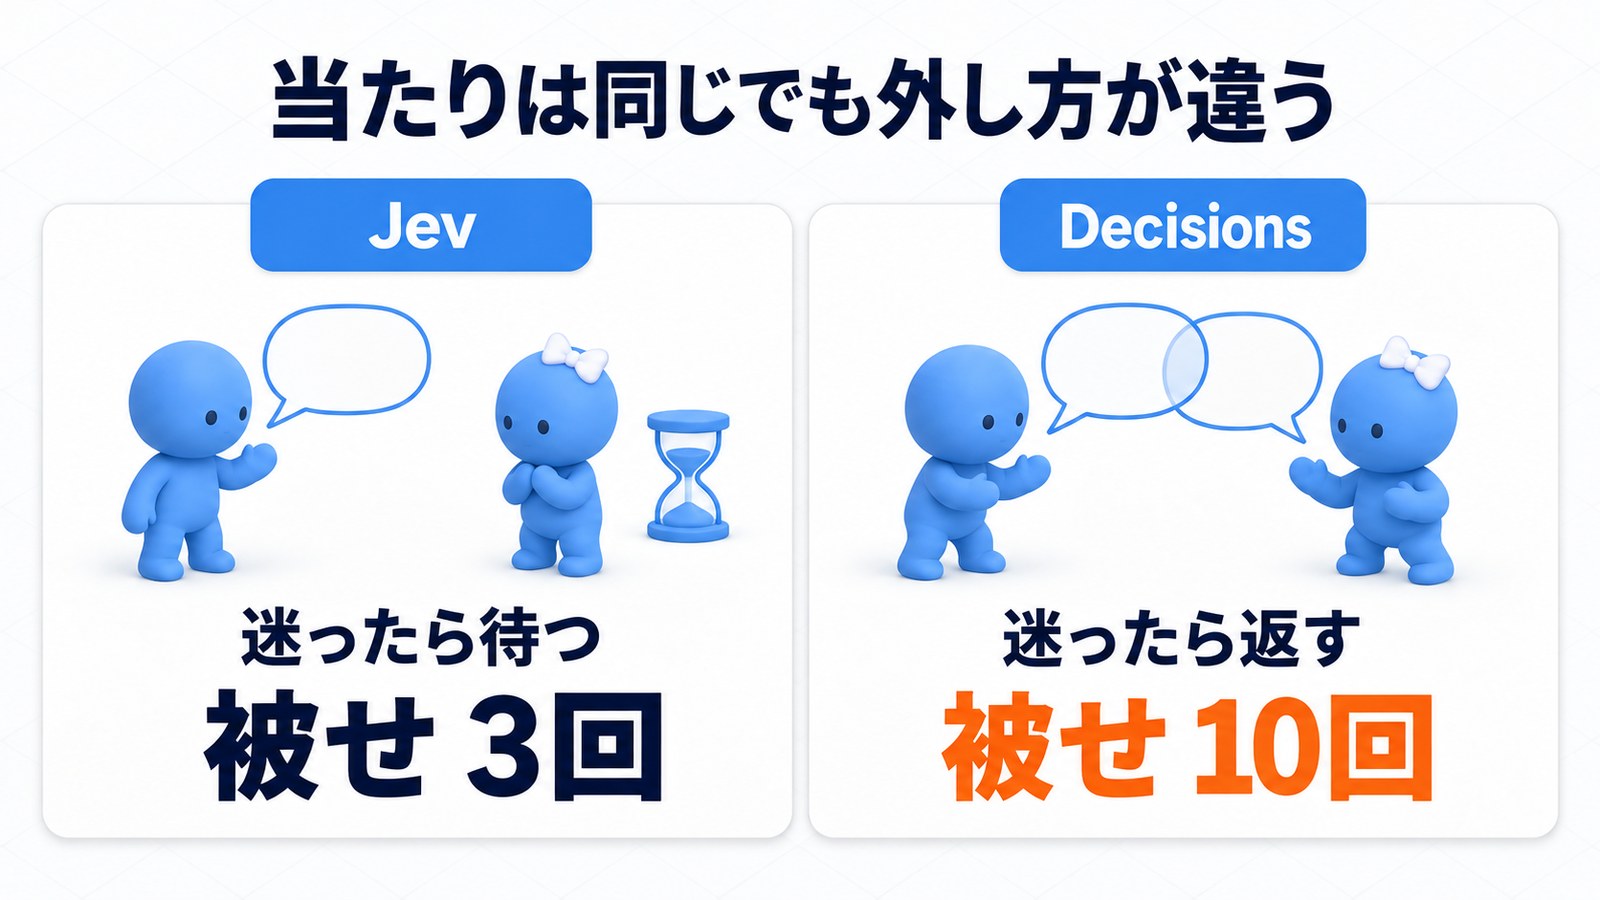
被せた10回のうち6回は、文の終わりに「-」が付いていました。文字起こしで、言いかけた言葉が途中で切れたときに付く印です。たとえば、ある参加者が「日本の首相教えて。-」で一息ついたとき、Jevは「まだ話す」と読んで待ちました。Decisions APIは「質問を言い終えた」と読んで、すぐ返そうとしました。この人は実際に、このあと「誰か。」と続けています。
実は、Jevへの質問には、この「-」の意味を一度も書いていませんでした。Jevは説明がなくても読めていて、私もそのことに気づいていませんでした。判定モデルを乗り換えると、前のモデルが説明なしで読めていたことが、質問の抜けとしてそのまま表に出てきます。
そこでDecisions API向けに質問を書き直し、「-」の意味と「迷ったら途中と答える」を足してみました。すると被せは10回から4回に減り、当たりも113/140とJevを上回りました。ただ今度は、言い終えた相手を待たせる時間が35秒に増えました。質問を直せば近づけることはできますが、同じにはなりません。被せと待ちの釣り合いは、Jevのほうが良いままでした。
仕草と表情の判断:正しいのに静かになる
エイヴァは、自分が話す文ごとに、合う仕草・ポーズ・表情を判定モデルで選んでいます。
まず、正解を付けた場面集で比べました。仕草が合うべき場面と、言葉が出ただけで仕草を出してはいけない場面を、対にして集めたものです。ここでは、体の動きそのものはDecisions APIが上でした。たとえば、相手の「ゆらゆら揺れる船は苦手」に、エイヴァが「ゆらゆらは酔いそうだよね」と返す文。ここで体を揺らしてしまうのは、言葉に釣られた間違いです。「指ハート流行ってるらしいよ」への返事で指ハートをしてしまうのも同じです。場面集にはこうした引っかけが2つあり、Jevは2つとも引っかかり、Decisions APIは2つとも避けました。
ただ、同じ場面集でDecisions APIが落とした4つは、どれも「体や持ち物のことを聞かれたか」の見張りでした(「それスマホ?」に、Jevは0.77、Decisions APIは0.03)。ふだんの控えでは、こうした見張りの一致率は95〜100%と高く見えていましたが、それは「いいえ」の場面ばかりだったからです。
では、ふつうの会話ではどうなるのか。エイヴァが実際の会話で話した文160本を使って、どれだけ体が動くかを数えました。
| エイヴァが実際に話した文160本 | Jev | Decisions API |
|---|---|---|
| 仕草が出る文 | 約60% | 約16% |
| ポーズが変わる文 | 約30% | 約10% |
| 出た仕草の種類(2回) | 24種類・24種類 | 12種類・8種類 |
| 表情が「ふつう」の文 | 77本 | 101本 |
(Decisions APIの仕草の種類が2回で違うのは、エイヴァが送るたびに選択肢の並びを入れ替えているからです。入力が同じなら同じ答えを返しますが、並びが変わると答えも変わります)
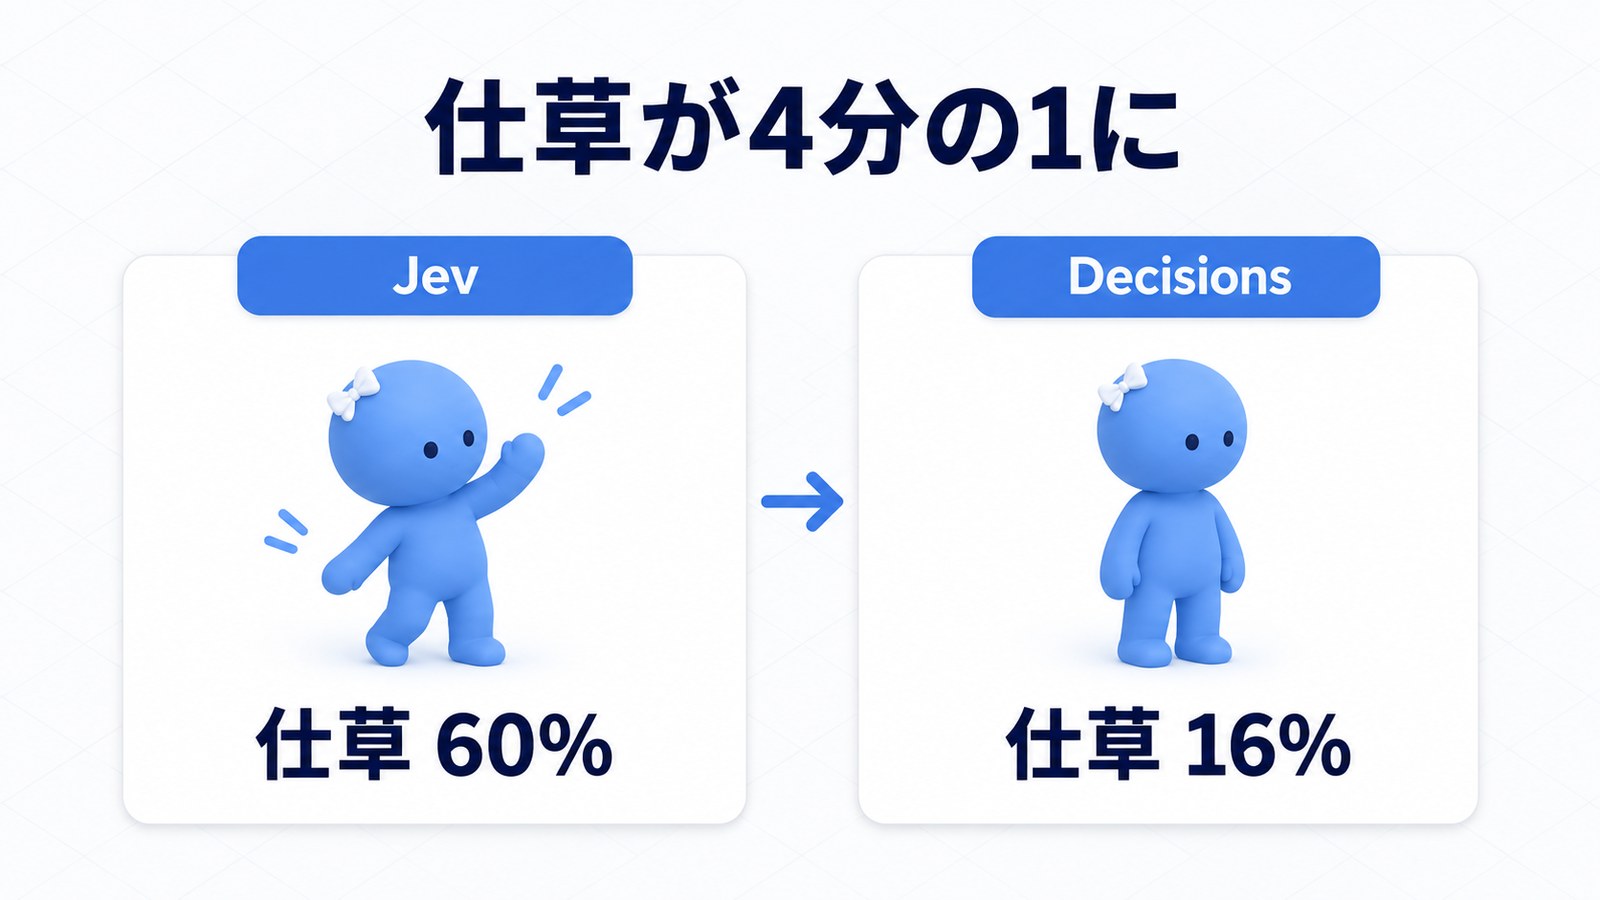
Decisions APIにすると、仕草は約4分の1に減ります。うなずきは15回から1回に、肩をすくめる仕草は16回から2回になりました。表情も「ふつう」に寄り、真顔でのツッコミや、むっとした顔が減ります。
さきほどの返り値の例は、相手の発言への反応を聞く短い質問で、そこではDecisions APIのほうがうなずきを強く選んでいました。それでも文ごとの仕草が減ったのは、ふつうの文での選び方が違うからです。160本のうち、Decisions APIは112本で「仕草なし」をいちばん上に選びました。Jevは23本です。仕草がはっきり合う場面では強く選び、合うかどうか微妙な文では「なし」を選ぶ。そのぶん、体が静かになります。
言葉に釣られずに引っかけを避ける慎重さと、ふつうの文で体を動かさない慎重さは、同じ性格の表と裏なのだと思います。正しさの試験だけを見ていたら、この違いには気づけませんでした。エイヴァは体が元気に動くことを大事にしてきたので、ここは大きな差でした。
気分の判断
エイヴァの気分も、言われたことを判定モデルで読み取って動かしています(仕組みの細かいところは、前回と同じく秘密にさせてください)。一致率の表で、段階の判断が54%といちばん開いていましたが、その多くがこの気分の判断です。
同じ会話でも、Decisions APIは、楽しさやいたずら心のような明るい気分を弱めに読みました。0〜1に直した平均で、楽しさはJevの0.47に対して0.30、いたずら心は0.54に対して0.32です。怒りや悲しみは、ほぼ同じでした。
この値をいまの仕組みにそのまま渡すと、明るい気分が動きにくくなり、エイヴァの遊び心も控えめになりそうです。
返答速度(レイテンシー)
会話では、返事までの間が自然さを大きく左右します。エイヴァの開発でも、返答速度はいちばん気をつけてきたところです。ここでは、判定モデルに質問を送ってから答えが返ってくるまでの時間(レイテンシー)を比べます。
「相手はもう言い終えたか」の判断は、エイヴァが返事を始める前に、必ず答えを待ちます。判定の0.2秒だけを見ると、ほんの一瞬に思えるかもしれません。でも、エイヴァが返事を声にするまでには、いくつもの段階を順番に通ります。相手が黙ったことを検出して、文字起こし(ElevenLabsのScribe v2 Realtime)が確定するのを待つ。判定モデルにいくつもの質問を組み合わせて聞き、言い終えたかや返事の形などを判断する。その結果をClaude(Sonnet 5.5)に渡して返事を書いてもらい、最初の一文が返ってきたところでElevenLabsのv4 Turboに送って声にしてもらう。その声が返ってきて、ようやく再生が始まります。
VRChatの集会で話した夜の記録(336回の返事)から、言い終えてから各段階が終わるまでの時間を中央値で並べると、次のようになります。
| 段階 | 言い終えてからの時間(中央値) |
|---|---|
| 相手が黙ったことを検出し、文字起こし(Scribe v2 Realtime)が確定する | 約0.55秒 |
| 判定の答えがそろい、返事を作り始める | 約0.78秒 |
| Sonnet 5.5から返事の最初の文字が返ってくる | 約2.0秒 |
| 返事の最初の一文がそろう | 約2.2秒 |
| v4 Turboから最初の声が返ってきて、再生が始まる | 約2.4秒 |
判定は、この流れの途中に挟まっています。判定が0.1秒遅れれば、うしろの段階もすべて0.1秒ずつ後ろにずれて、声が出るのも0.1秒遅れます。しかも、判定を待つのは1回とは限りません。この夜は3回に1回ほど、文字起こしが確定する前の判定に続けて、確定した文でもう一度判定を待っていました。その場面では、差も2回分たまります。
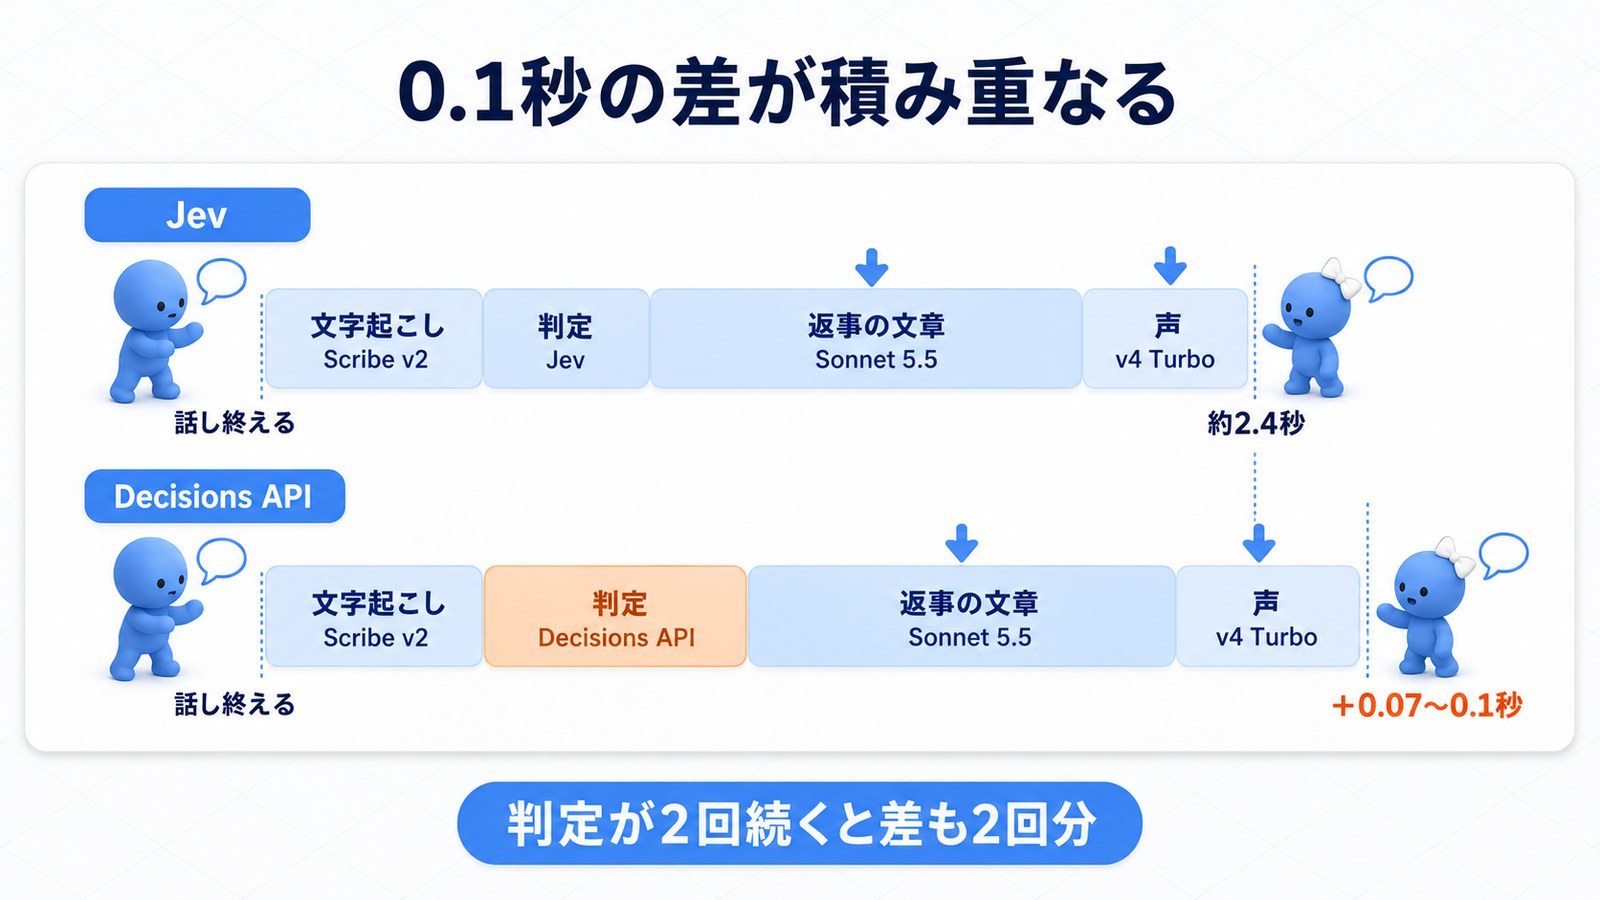
測り方は2通りです。言い終えたかの判断は、Jevは本番の会話の記録(約3,500回)から、Decisions APIは試しに送った15回から出しています。15回は少ないので、こちらは参考の値です。仕草と表情の判断は、同じ文160本を同じ時間に両方へ2回ずつ送ったので、条件のそろった比べになっています。どちらの測り方でも、Decisions APIのほうが時間がかかりました。
| 判断1回にかかった時間 | Jev | Decisions API |
|---|---|---|
| 言い終えたかの判断(中央値) | 約0.19秒 | 約0.26秒 |
| 言い終えたかの判断(10回に1回の遅いとき) | 約0.24秒 | 約0.33秒 |
| 文ごとの仕草と表情の判断(中央値) | 約0.16秒 | 約0.26秒 |
差は1回あたり0.07〜0.1秒ほどです。この差だけを見れば小さく見えますが、返事までの約2.4秒は、こうした段階の積み重ねでできています。エイヴァの開発では、この流れを一段ずつ、少しずつ削ってきました。判定だけで0.1秒増えれば、その積み重ねを打ち消すことになります。テンポよく返すことを大事にしてきたエイヴァにとって、見過ごせない差です。
Jevを使い続けると決めた理由
ここまでで、Decisions APIへの書き換え自体は難しくないことが分かりました。それでも、乗り換えないことにしました。理由は4つあります。
ひとつめは、 確率の出し方が、アバターの性格になる ことです。質問の書き方や、どのくらいの確率で待つか、仕草を出すかといった調整は、これまでJevと一緒に育ててきました。モデルを替えると、その積み重ねごと変わってしまいます。正解のある判断ではほぼ互角でも、間の取り方や体の動き、気分の出方のような、正解のない「その子らしさ」の部分で差が出ました。
ふたつめは、 返答が遅くなる ことです。今回の測定では、判断1回あたり0.07〜0.1秒ほど長くかかりました。返事までの流れの途中にある判断なので、この差はそのまま声が出るまでの時間に足されます。
みっつめは、 節約できる額が小さい ことです。本番の会話でJevにかかる費用は、1時間あたり約0.2ドルです。得意な判断だけをDecisions APIに移すハイブリッドも考えましたが、それで減るJevの費用は1時間あたり0.1ドル前後でした。しかも、これまでのJevの費用の大半は、本番の会話ではなく、調整のたびの動作確認に使ったものでした。つまり、実際に会話で動かすためのコストは、いまのJevのままでも十分に低いということです。
よっつめは、 仕組みが増える ことです。ハイブリッドにすると、判断ごとに送り先を振り分ける仕組みと、2通りの質問の手入れが必要になります。さらにDecisions APIは日付つきの版を指定できないので、もし中身が変わったときに気づけるよう、答えを見張る仕組みも要ります。
いまの会話量なら、乗り換えて浮くのは月に数ドルです。会話の自然さが変わってしまうなら、乗り換える理由にはなりません。トークアバターでは、コストより体験を優先することにしました。
そのかわり、Decisions APIは画像を見る判断で使うつもりです。Jevも1.14で画像に対応していますが、視覚の判断は、間の取り方や気分のようにエイヴァの思考に直接効く判断ではないので、判定モデルの性格の違いが会話に響きにくいのです。いまの流れにアタッチメントのように後付けで組み込み、判断の材料を1つ増やす。そんな気軽な使い方になります。VRChatの画面から「誰が話しているか」「こちらを見ているか」といった確認を、毎月のクレジットの範囲で気軽に投げられるDecisions APIは、こうした使い方にちょうどよい相手です。乗り換えではなく、付け足しとして使います。
乗り換える前に測ること
今回の比べ方は、ほかの判定モデルにもそのまま使えます。乗り換える前に、次の5つを測っておくと安心です。
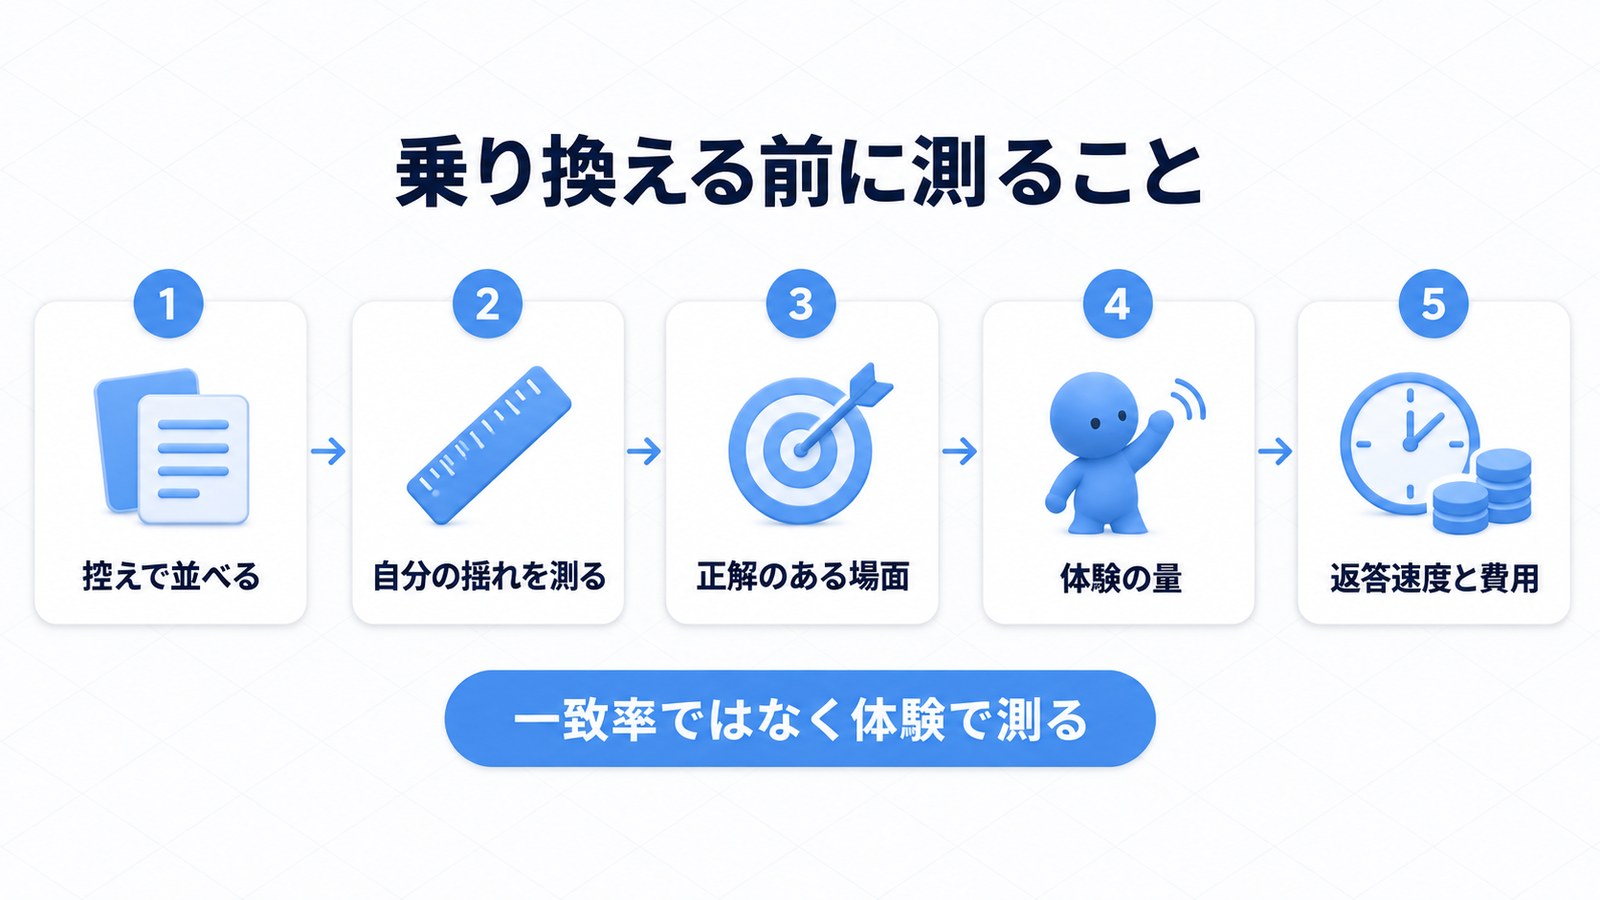
- 控えで並べる :本番で送った質問と答えを保存しておき、同じ内容を新しいモデルにも送る。いまのモデルの答えは手元にあるので、費用も小さく済む
- いまのモデル自身の揺れを測る :同じ質問を、いまのモデルにもう一度だけ聞く。同じモデルでも答えは少し変わるので、その幅を、モデルを替えたときの差を読む目安にする
- 正解のある場面で比べる :手で正解を付けた例や、過去の会話の流し直しのように、本当に起きたことが分かる場面で比べる。めったに起きないことを見張る質問は、「いいえ」の場面ばかりで一致率が高く見えるので、「はい」の場面だけでも比べる
- 体験の量を測る :正しさだけでなく、ふつうの会話でどれだけ反応するかも見る。エイヴァの仕草のように、正しいのに量が減ることがある
- 返答速度と費用を測る :返答速度は中央値だけでなく、たまに遅くなるときも見る。費用は、本番と動作確認のどちらにいくらかかっているかを分けて見る
いちばん大事なのは、 一致率ではなく体験で測る ことでした。一致率だけを見ていたら、「判断の1割が逆になる」ということしか分かりません。被せた回数や仕草の量で測ってはじめて、それがエイヴァにとって何を意味するのかが見えてきました。
まとめ
OpenAIのクレジット配布をきっかけに、エイヴァの判定モデルをDecisions APIに乗り換えようとして、やめました。
今回試した範囲では、Decisions APIは同じ入力に毎回同じ答えを返し、正解のある判断ではJevとほぼ互角でした。プロンプトインジェクションの検知では、Jevより良い結果も出ています。画像を判断の材料にできるのも強みです。
それでも、トークアバターの判定モデルは、正しさだけでは選べませんでした。相手の話に被せるか待つか、文ごとにどれだけ体を動かすか、いたずら心をどれくらい感じるか。正解のないところで、判定モデルの性格がそのままアバターの性格になります。
最後に、公平のために書いておきます。エイヴァは、これまでJevを前提に調整してきました。今回の比べ方は、どうしてもJevに有利な条件です。最初からDecisions APIで調整していれば、Decisions APIを前提にした自然な振る舞いを作れていたかもしれません。
ただ、その場合も向きが逆になるだけで、Decisions APIからほかの判定モデルに乗り換えようとすれば、同じ課題にぶつかると思います。判定モデルの性格は、それを前提に調整した振る舞いの中に溶け込んでいくからです。だからこそ、乗り換えるときに何が起きるのかを、こうして記録に残しておきます。
料金と仕様は、記事を書いた時点(2026年10月)の情報です。最新の情報は、OpenAIのDecisions APIのガイドとTypeSafe AIで確かめてください。